Nach einem gewissen Stillstand in den vergangenen Jahren sieht sich der Discovery-Markt aktuell einem hohen Veränderungsdruck ausgesetzt. Die Integration von künstlicher Intelligenz und cloudbasierten Technologien in Arbeitsabläufe, aber auch KI-generierte Inhalte als Gegenstand von Untersuchungen sind neue Phänomene, die sich auf die bisherigen Methoden und Analyseverfahren im Rahmen von Litigation, Investigation, Compliance, Cyber und Regulatory auswirken. Dabei werden Fragen aufgeworfen wie: Welche eDiscovery-Kosten sind noch gerechtfertigt? Werden Agenten bald die eDiscovery-Teams ersetzen? Ist der Weg in die Cloud alternativlos – und wer im Unternehmen trifft diese Entscheidung?
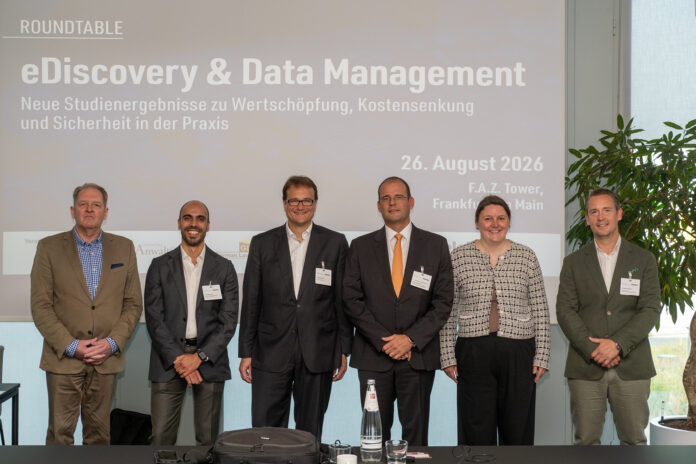
In Kooperation mit Deloitte lud der Deutsche AnwaltSpiegel am 26.08.2026 zu einem Roundtable in den F.A.Z. Tower nach Frankfurt am Main ein, um mit Experten aus Unternehmen und Wirtschaftskanzleien die Ergebnisse einer aktuellen Studie zu diskutieren.
Grundlage der Diskussion war eine Bilendi-Umfrage unter 505 Unternehmen aller Branchen und Größen in Deutschland, Österreich und der Schweiz, die Deloitte im Jahr 2025 erhoben hat – mit dem Ziel, sie künftig jährlich fortzuschreiben. Erste Ergebnisse für 2026 liegen bereits vor und bestätigen das Lagebild weitgehend.
Auf dem Podium diskutierten Thomas Fritzsche, Head of Discovery & Data Management, sowie Dr. Klara Weiand, Head of Analytics & Innovation (beide Partner bei Deloitte), mit Dr. Martin Mozek, Director Compliance bei Samsung Electronics, Kaan Gürer, LL.M., Partner Antitrust & Foreign Investment Group bei Linklaters, und Dr. Sebastian Jungermann, Partner bei Arnecke Sibeth Dabelstein. Moderiert wurde die Veranstaltung von Prof. Dr. Thomas Wegerich, Herausgeber des Deutschen AnwaltSpiegels.
Discovery in der DACH-Region
Zum Auftakt erläuterten Thomas Fritzsche und Klara Weiand die wesentlichen Erkenntnisse aus der Erhebung in einem kurzen Impulsvortrag. Demnach sei Discovery längst kein Thema mehr nur für Recht, Compliance und IT – Data-Leakage-Vorfälle machten Cybersecurity zu einem zentralen Akteur. Auch Corporate Security und Interne Revision integrieren zunehmend Methoden und Technologien aus der Discovery. Zwar sei diese eine Querschnittsdisziplin geworden, doch bleibe die notwendige bereichsübergreifende Zusammenarbeit vielerorts hinter den Anforderungen zurück.
Das Discovery-Geschäft im deutschsprachigen Raum erweist sich nach den Studienergebnissen als kleinteilig: Die meisten Unternehmen berichten von weniger als zehn Fällen in den zurückliegenden fünf Jahren, die Laufzeiten liegen überwiegend zwischen einem und sechs Monaten. Gleichwohl treten Großverfahren – mitunter über mehrere Jahre – regelmäßig auf.
Besonders aufschlussreich sind die Unterschiede bei den Reviewkosten, die pro Dokument von unter 10 Cent bis zu mehr als 2 Euro schwanken. Fritzsche erläuterte den Zusammenhang zwischen Fallvolumen und Kostenbewusstsein: Unternehmen mit wenig Erfahrung neigten zunächst dazu, Kosten zu unterschätzen. Mit steigendem Fallaufkommen wachse zwar das Bewusstsein für den tatsächlichen Aufwand, aber auch die Fähigkeit zur Standardisierung – was die Kosten wieder begrenze.
Rund 70% der befragten Unternehmen führen Discovery-Projekte vollständig inhouse durch; nur 6% lagern sie vollständig aus. Werden Teilleistungen vergeben, dann vor allem spezialisierte Tätigkeiten – Digitalisierung, Datensicherung, Datenanalyse, Datenhosting und Digital-Forensics –, nicht aber die Kernverantwortung.
Der klassische Dokumentenreview steht nach den Studienergebnissen möglicherweise vor dem Aus. Automatisierte Analysen und KI verdrängen manuelle Prüfprozesse. Die zentrale Frage lautet nach Weiand nicht mehr, ob KI eingesetzt wird, sondern in welchen Anwendungsfällen ihre Ergebnisse belastbar genug sind; Fakt und Fiktion greifen im hochanspruchsvollen Discovery-Umfeld noch zu stark ineinander.
Weiand unterschied dabei zwischen zwei Fallprofilen: Standardisierbare Untersuchungen mit klaren Relevanzkriterien profitierten stark von Automatisierung – der Fokus verlagere sich von der Bearbeitung hin zu Qualitätssicherung und Freigaben. Komplexe Investigations hingegen, bei denen sich die Fragestellung erst im Verlauf konkretisiert, blieben kostenintensiv: Qualitätssicherung, juristische Einordnung, Dokumentation und Steuerung seien dabei die Kostentreiber. Dass der klassische Dokumentenreview in der Studie als ausgelagerte Leistung kaum genannt wird, sei kein Zufall, denn viele Unternehmen führten ihn schlicht nicht mehr in dieser Form durch.
KI und Kartellrecht – Discovery in der Praxis
In der anschließenden Diskussion machte Martin Mozek auf wachsende Anforderungen und eine veränderte Erwartungshaltung beim Sammeln und Auswerten von Daten sowie bei der Bewertung von Sachverhalten aufmerksam, die durch den Einsatz von KI entstehen. Diese verschiebe zwar die Wertschöpfungskurve, ersetze aber keine Experten. Wer neue Medien und Methoden erfolgreich einsetzen will, braucht Fachleute, die KI-gestützte Prozesse kontrollieren, Ergebnisse kritisch hinterfragen und Risiken beherrschen. Fritzsche wies in diesem Zusammenhang auf ein Nachwuchsproblem hin: Junge Kollegen, die mit KI aufgewachsen sind, nähmen deren Ergebnisse intuitiv als verlässlich an – auch wenn im Grundkurs bereits vor Halluzinationen gewarnt wird.
Der Chatbot als Anwendungsfall verdeutlichte die Spannung: Für standardisierbare Fragestellungen und das Early-Case-Assessment liefern Discovery-Chatbots bereits Mehrwert. Bei großen, heterogenen Datenmengen sei die Funktionalität jedoch begrenzt, denn man muss schon sehr viel wissen, um die Ergebnisse einordnen zu können. Eine erwünschte „Demokratisierung“ des Datenzugangs werde erst dann eingelöst, wenn auch diejenigen, die mit den Daten arbeiten, verstehen, was die KI tatsächlich liefert – und was nicht.
Kaan Gürer konzentrierte sich auf den kartellrechtlichen Use-Case. KI sei in klassischen Kartellverfahren bereits nützlich, aber noch überwiegend unterstützend tätig. Bei Vorselektion, Priorisierung, Data-Privacy-Review und Early-Case-Assessment leiste KI heute Erhebliches. Vollständigkeit und Nachvollziehbarkeit jedoch – beides zentrale Anforderungen der Behörden – könne KI noch nicht gewährleisten.
Als konkretes Beispiel verwies er auf eine kartellrechtliche Untersuchung, bei der ein eingesetztes KI-Modell trotz gezielter Prompts immer wieder dieselben Dokumente aus der Schweiz lieferte – relevante Ergebnisse aus Deutschland oder Frankreich blieben aus. Das Problem ließ sich auch im Dialog mit dem KI-Anbieter nicht lösen, da Reproduzierbarkeit und Transparenz fehlten. Sein Fazit lautet daher: „Nicht: Mensch oder Maschine, sondern: Wo nutzt man clever den Menschen und wo die Maschine?“ Besonders wertvoll sei KI bei Mustererkennung und bei der ersten rechtlichen Kategorisierung großer Datenmengen – dort, wo repetitive Selektionsarbeit anfällt. Behörden, so Gürer, seien für Gespräche über Methodik durchaus offen; die Europäische Kommission etwa mehr als die britische Competition and Markets Authority (CMA).
Sebastian Jungermann weitete die Perspektive auf Kartellschadensersatzverfahren, US-Litigation-Support und M&A-Due-Diligence aus. Auch dort führe KI zu erheblichen Effizienzgewinnen – insbesondere angesichts wachsender Datenvolumina, die selbst zunehmend KI-generiert und damit „erklärungsbedürftig“ seien: Wenn Maschinen mit Maschinen kommunizieren, weiß am Ende möglicherweise niemand mehr, was tatsächlich passiert ist. Ergebnisse seien teilweise nicht belastbar, irreführend oder schlicht falsch – das könne den erfahrenen Berater noch nicht ersetzen.
Jungermann verwies zudem auf eine neue Realität im Defense-Bereich: Unternehmen, die vom zivilen in den Rüstungssektor eintreten, sind mit Hochsicherheitsanforderungen konfrontiert, bei denen bestimmte Daten nicht in die Cloud dürfen. Das verändere das Datenmanagement grundlegend. Gleichzeitig wachsen Discovery-Software, Datenräume und Matter-Management zunehmend zusammen. Wer in diesem Markt gewinnen wolle, müsse heute in Analysekompetenzen und digitalforensische Fähigkeiten in der IT investieren.
Menschlicher Faktor und Mitbestimmung beim Datenmanagement
Eine Frage aus dem Publikum griff den menschlichen Faktor bei Untersuchungen auf. Das Podium war sich einig, dass „klassische“ Interviews mit den zuständigen Personen unverzichtbar bleiben. Denn es beginne immer mit Gesprächen, weil man in komplexen Fällen schlicht noch nicht wisse, wonach man suchen müsse – und wer überhaupt als Custodian relevant sei. Mozek brachte es auf den Punkt: „Man verschwendet oft viel Zeit mit unglaublich vielen Dokumenten. Wenn ich auch nur zwei Monate früher hätte fragen können, hätte ich das Thema schon längst erledigt.“
Gürer berichtete, dass sich die Form der Interviews verändere – mehr Digitalisierung, mehr Transkription –, dass bei Schlüsselpersonen aber der persönliche Kontakt unersetzlich bleibe: Körpersprache, Widersprüche, das investigative Gespräch. Fritzsche schilderte einen konkreten Fall, bei dem erst ein direktes Gespräch offenbarte, dass ein Team die betreffenden Chats gelöscht hatte – woraufhin die Backups herangezogen wurden, die den vollständigen Chat enthielten. „In diesen angespannten Situationen ist das Gespräch einfach erforderlich.“
Eine weitere Publikumsfrage rückte ein bisher kaum diskutiertes Thema in den Mittelpunkt: Mitarbeiter-Prompts als potentielle Erkenntnisquelle in Untersuchungen. Fritzsche hielt Prompts für eine der vielversprechendsten Datenquellen aus Aufdeckungssicht: „Bei Prompts darf man annehmen, dass da noch keiner darüber nachdenkt, dass diese ausgewertet werden könnten.“ Mozek bestätigte, dass die Überwachung von KI-Nutzung im Unternehmen aktuell eine offene Diskussion sei. Gürer wies auf einen pikanten Aspekt hin: Prompts könnten zeigen, wie Mitarbeiter Complianceschulungen nutzen – etwa um zu recherchieren, wie kartellrechtliche Verstöße begangen werden, ohne dass es auffällt. Er erinnerte an den Fall Michelin, in dem eine Kartellbehörde signalsprachliche Äußerungen in Earnings-Calls mit KI-Unterstützung aufgedeckt hatte – eine neue, geschützte Form der Preisabsprache, die wiederum durch KI enttarnt wurde.
Die Diskussion führte direkt zur Frage der Mitbestimmung. Mozek empfahl eindringlich, Betriebsräte frühzeitig und umfassend einzubinden – auch bei nicht mitbestimmungspflichtigen Themen. Klare Betriebsvereinbarungen, die den Zugriff auf Unternehmensdaten bei Untersuchungen regeln, schafften Rechtssicherheit und ersparten im Ernstfall kostspielige Verzögerungen. Gürer ergänzte einen entscheidenden Aspekt: Behörden interessiere es nicht, was intern vereinbart wurde – sie nähmen mit, was sie vorfänden. Wer Waffengleichheit mit den Behörden haben will, muss sofort handlungsfähig sein.
Neue Risikofelder: Von Dark Data zu KI-generierten Inhalten
Dark Data, lange Zeit ein Schreckensbild in der Discovery, hat an Bedeutung verloren. Die neuen Risikofelder heißen KI-generierte Inhalte, mobile Endgeräte, Clouddaten, Social-Media-Posts und Transaktionsdaten – mit KI-generierten Inhalten an der Spitze.
Fritzsche wies auf eine fundamentale Verschiebung hin: Bislang galt: Vorhandene Daten beziehen ihren Beweiswert daraus, dass man ihre Echtheit bezeugen kann. Wenn aber KI in Premiumqualität Daten erzeugt, die von echten nicht mehr zu unterscheiden sind, entsteht ein neues Grundproblem: „Wir werden im Discovery-Prozess ganz am Anfang, bei der Beweisdatenerhebung, erklären müssen, warum wir davon ausgehen dürfen, dass die Daten belastbar sind.“ Deepfakes, d.h. täuschend echte Voicemails und Videonachrichten, sind dabei nur die Spitze des Eisbergs. Eine offene Frage, die die Runde beschäftigte, bleibt: Entlarvt die KI die KI?
Beim Thema Cloud zeigt die Studie ein überraschendes Bild: Während über eingesetzte Software und Datenverarbeitung intensiv diskutiert wird, sehen die meisten Unternehmen kaum Risiken bei der Speicherung in der Cloud. Die Herausforderung liegt nicht in der Cloud selbst, sondern in der Beherrschung der darin entstehenden Datenmengen.
Den Abschluss bildete ein Blick in die nähere Zukunft: Weiand prognostizierte, dass einzelne KI-Use-Cases in den kommenden Jahren zu integrierten Workflows zusammenwachsen werden – nicht mehr als isolierte Einzellösungen, sondern als durchgehender Ablauf über den gesamten eDiscovery-Prozess hinweg. Fritzsche ergänzte: „Mehr Agenten in der Discovery werden kommen. Aber das Erfahrungslevel wird gerade erst gesammelt – und der Austausch, den wir jetzt führen, wird über die nächsten Jahre extrem wichtig sein.“ Jungermann mahnte, den Schwund an Spezialisten zu verhindern: „Wenn die Experten nicht mehr ausgebildet werden, weil junge Leute nicht eingestellt werden, bauen wir eine riesige Lücke auf.“
Mozek schloss mit einem Bild, das die Runde treffend zusammenfasste: Complianceanfragen, die so gut formuliert sind, dass man Zweifel bekommt, ob sie wirklich ein Mensch geschrieben hat – und ob die Antwort des Beraters womöglich schon wieder von einer KI weiterverarbeitet wird.
Man darf also gespannt sein, in welche Richtung sich Discovery und Datenmanagement in den kommenden Jahren entwickeln werden.